Uma loja virtual publica trinta páginas de categoria novas, escreve textos cuidadosos e, três meses depois, descobre que o Google indexou apenas onze delas. As outras dezenove ficaram de fora por causa de um bloqueio no robots.txt que ninguém lembrava de ter configurado.
O SEO técnico reúne os ajustes que evitam esse tipo de perda, porque nenhum texto bem escrito aparece em um resultado quando o robô não consegue chegar até ele.
O assunto ganhou um peso extra nos últimos anos. Além do Google, hoje os rastreadores de ferramentas como ChatGPT e Perplexity também visitam o site, e cada um deles tem limites próprios para ler uma página.
Um site que carrega devagar, esconde o conteúdo atrás de scripts ou repete a mesma página em dez endereços perde espaço nos dois mundos ao mesmo tempo.
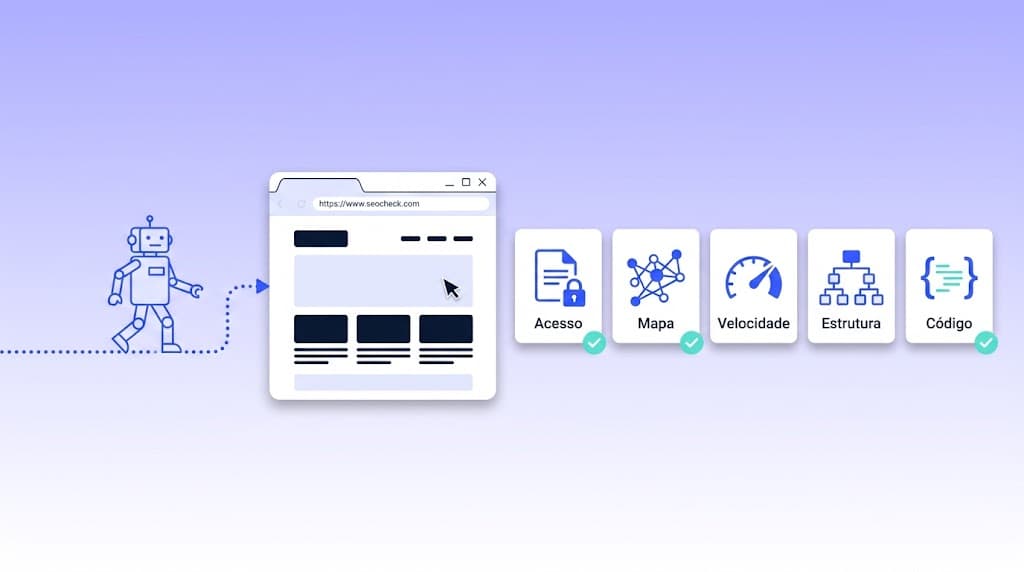
A seguir, a ordem de revisão que costuma funcionar melhor: primeiro o acesso dos robôs, depois a velocidade, a arquitetura e os dados estruturados, e por fim os pontos específicos de visibilidade em IA.
O que é SEO técnico e por que ele vem antes do conteúdo
O SEO técnico é o trabalho de preparar a estrutura do site para que buscadores consigam rastrear, interpretar e indexar cada página.
Ele cuida de tudo o que acontece antes de alguém ler o texto, como o acesso dos robôs, a velocidade de carregamento e a forma como as informações são marcadas no código.
Um bom exemplo é a página de preços de uma empresa de software. Se ela só carrega depois que um script roda, o robô pode receber uma página quase vazia e concluir que não há nada ali para indexar.
O conteúdo existe para o usuário, mas não existe para quem decide o que aparece nos resultados.
Na prática, o trabalho se divide em quatro frentes:
- Rastreamento: define quais páginas os robôs podem visitar e com que facilidade chegam até elas.
- Indexação: decide quais das páginas visitadas entram de fato no índice e sob qual endereço.
- Renderização: garante que o conteúdo apareça para o robô da mesma forma que aparece para o usuário.
- Experiência: mede velocidade, estabilidade visual e uso em celular, que influenciam tanto o ranking quanto a conversão.
Vale a ressalva de que o SEO técnico não substitui conteúdo relevante. Uma página impecável no código, mas sem resposta útil, continua sem resultado. Por isso a ordem importa: primeiro se garante o acesso, depois se disputa a relevância.
Como funcionam o rastreamento e a indexação
Antes de aparecer em qualquer resultado, uma página passa por três etapas: o robô descobre a URL, baixa o conteúdo e decide se vai guardá-la no índice.
Um erro em qualquer uma dessas etapas tira a página da disputa, e o problema costuma passar despercebido porque o site continua funcionando normalmente para quem o visita.
Os arquivos e as tags que mais interferem nesse processo são os que seguem.
Robots.txt e sitemap XML
O robots.txt é o arquivo que diz aos robôs quais áreas do site eles podem visitar. Uma linha mal escrita pode bloquear o site inteiro, como acontece quando um "Disallow: /" usado no ambiente de testes vai parar em produção durante uma migração.
O sitemap XML cumpre o papel inverso, que é listar as URLs que merecem ser rastreadas. Ele funciona melhor quando contém apenas páginas indexáveis, com status 200 e sem redirecionamento. Por isso um sitemap com URLs quebradas ou bloqueadas passa ao buscador um sinal contraditório.
Alguns cuidados rápidos:
- Testar o robots.txt após qualquer migração, antes de liberar o site.
- Declarar o endereço do sitemap dentro do robots.txt.
- Remover do sitemap páginas com noindex, redirecionadas ou com erro.
- Atualizar o arquivo de forma automática sempre que uma página for criada ou despublicada.
Canonical, redirecionamentos e páginas duplicadas
A mesma página costuma existir em várias versões: com e sem "www", com parâmetros de rastreamento, com barra final ou sem ela.
Quando o buscador encontra todas, ele precisa escolher uma, e nem sempre escolhe a que a empresa preferiria. A tag canonical indica qual endereço deve receber o ranking.
Os redirecionamentos 301 completam o trabalho ao levar páginas antigas para as novas sem perder o histórico de links. O erro mais frequente aparece em cadeias, quando
A redireciona para B, que redireciona para C. Cada salto extra consome tempo de rastreamento e aumenta a chance de o robô desistir no meio do caminho.
Velocidade e Core Web Vitals
Os Core Web Vitals são três métricas que o Google usa para medir a experiência real de uso de uma página. O LCP (Largest Contentful Paint) mede quanto tempo o maior elemento visível leva para aparecer, e o limite considerado bom é de 2,5 segundos.
O INP (Interaction to Next Paint) mede a resposta aos cliques e toques, com limite de 200 milissegundos.
A terceira métrica, o CLS (Cumulative Layout Shift), mede o quanto o layout se mexe durante o carregamento, e o valor bom fica abaixo de 0,1. Quem já tentou tocar em um botão que se deslocou no último instante sabe como essa falha frustra o usuário.
Imagens sem dimensões definidas e anúncios que carregam tarde estão entre as causas mais comuns.
Para melhorar esses números sem reescrever o site inteiro, a lista abaixo costuma render mais:
- Comprimir imagens e servi-las em formatos modernos, como WebP ou AVIF.
- Adiar scripts de terceiros que não são necessários na primeira tela.
- Reservar o espaço de imagens, vídeos e banners no código para evitar saltos de layout.
- Usar cache e uma CDN para aproximar os arquivos de quem acessa.
A velocidade ainda afeta a conversão, e esse ganho muitas vezes justifica o investimento sozinho. Vale destacar que os resultados mudam conforme o dispositivo e a conexão, portanto o ideal é medir com dados de campo, no relatório do Search Console, e não apenas com testes de laboratório.
Arquitetura do site e links internos
A arquitetura define quantos cliques separam a página inicial de cada conteúdo. Páginas a mais de quatro cliques da home recebem menos visitas de robôs e, em geral, menos autoridade interna. Uma estrutura em silos, com categorias claras e subpáginas ligadas ao tema, ajuda o buscador a entender o que o site cobre.
Os links internos fazem o trabalho de distribuir essa autoridade. Uma âncora descritiva, como "auditoria de SEO técnico", informa ao robô sobre o que é a página de destino, enquanto "clique aqui" não informa nada.
A âncora funciona como uma etiqueta que acompanha a URL, e o buscador usa esse texto para classificar a página.
Entre os problemas mais comuns de arquitetura estão:
- Páginas órfãs: conteúdos publicados que nenhum outro link do site aponta, e que o robô só encontra por acaso.
- URLs confusas: endereços com parâmetros longos ou códigos que não dizem nada sobre a página.
- Menus em JavaScript: navegação que só aparece depois de um clique e que o robô não consegue seguir.
- Paginação mal resolvida: listas longas sem links claros entre as páginas.
Um exemplo simples ajuda a ver o efeito. Uma consultoria com 200 artigos no blog descobriu que 60 deles não recebiam nenhum link interno. Depois de ligá-los a páginas de serviço relacionadas, boa parte passou a ser indexada em poucas semanas, sem qualquer mudança no texto.
Dados estruturados e schema markup
Os dados estruturados são um bloco de código, normalmente em JSON-LD, que descreve o conteúdo da página em uma linguagem que as máquinas entendem.
O vocabulário vem do schema.org e cobre tipos como Organization, Article, Product, FAQPage e LocalBusiness. A marcação diz ao robô o que cada informação é, ao invés de obrigá-lo a adivinhar a partir do texto.
Em uma página de produto, por exemplo, o schema pode informar nome, preço, disponibilidade e avaliações. Em um artigo, ele aponta autor, data de publicação e data de atualização. Esses campos entregam justamente os sinais de autoria e recência que mecanismos de IA costumam usar para decidir em qual fonte confiar.
Alguns cuidados evitam dores de cabeça:
- Refletir no código apenas o que está visível na página, sem inventar avaliações ou preços.
- Validar a marcação no teste de resultados em destaque do Google antes de publicar.
- Manter os dados sincronizados, porque um preço antigo no schema e um novo no texto geram conflito.
Nem toda marcação gera um destaque visual na busca, e o Google restringiu alguns formatos nos últimos anos. Ainda assim, o schema continua útil para identificar entidades, como a empresa, os autores e os produtos, o que ajuda tanto o buscador tradicional quanto os mecanismos de resposta.
SEO técnico para mecanismos de IA
Os rastreadores de IA têm identificações próprias no robots.txt, como o GPTBot, da OpenAI, e o PerplexityBot.
Uma regra genérica de bloqueio, criada anos atrás para conter robôs de coleta de dados, pode estar impedindo sem querer que as ferramentas de IA leiam o site. Por isso a primeira checagem é abrir o robots.txt e conferir quais agentes estão liberados.
A segunda checagem envolve JavaScript. O Google consegue renderizar scripts, mas muitos rastreadores de IA recebem apenas o HTML inicial.
Se o texto principal da página aparece só depois da execução do script, a IA enxerga uma página vazia e não tem o que citar. A renderização no servidor (SSR) ou a pré-renderização resolvem o problema ao entregar o conteúdo já pronto.
Duas práticas simples completam esse bloco:
- Colocar o conteúdo principal, como títulos, respostas e dados, no HTML inicial da página.
- Indicar a data de atualização de forma visível e também no schema.
Vale a ressalva de que liberar um rastreador não garante citação. O acesso é a condição mínima, e o que decide a menção é a qualidade e a especificidade do conteúdo.
Os critérios dessa segunda etapa pertencem aos fundamentos de GEO, mas o ponto de partida continua sendo o acesso técnico.
Como fazer uma auditoria de SEO técnico
Uma auditoria organiza todos os pontos anteriores em uma sequência de verificação. O objetivo é encontrar primeiro os problemas que bloqueiam páginas inteiras e só depois os que causam perdas pequenas.
Um site de 500 páginas com um bloqueio no robots.txt precisa mais de uma linha corrigida do que de cem ajustes de título.
O roteiro abaixo funciona para a maioria dos sites:
- Verificar o robots.txt e as tags noindex para confirmar que as páginas importantes estão liberadas.
- Comparar o sitemap com o relatório de cobertura do Search Console, para achar páginas que não foram indexadas.
- Rodar um rastreador, como o Screaming Frog, para listar erros 404, cadeias de redirecionamento e páginas órfãs.
- Medir os Core Web Vitals dos modelos de página mais visitados.
- Testar a renderização do conteúdo principal com o JavaScript desativado.
Cada achado entra em uma lista com impacto e esforço. Os itens de alto impacto e baixo esforço vão primeiro, como corrigir um redirecionamento em cadeia ou liberar um diretório bloqueado. A auditoria repete-se a cada trimestre, porque novos lançamentos e plugins costumam reabrir problemas antigos.
Como saber se o SEO técnico do seu site está funcionando
Depois de aplicar os ajustes, é preciso confirmar o efeito com dados. O sinal mais direto vem do Search Console, onde a quantidade de páginas indexadas e a de páginas com erro mostram se o buscador está conseguindo ler o site.
Uma queda nas exclusões e uma alta nas páginas válidas indicam que o trabalho surtiu efeito.
Para a parte de IA, o acompanhamento é outro. Vale conferir:
- Logs do servidor: mostram se GPTBot, PerplexityBot e outros agentes visitam as páginas prioritárias.
- Teste de citação: consiste em fazer as perguntas dos seus clientes em diferentes ferramentas e anotar quando a marca aparece.
- Cobertura de renderização: compara o HTML recebido pelo robô com o que o usuário vê.
Esses três pontos formam um quadro que o rank tracking sozinho não entrega. Uma página pode estar na primeira posição do Google e ainda ficar fora das respostas de IA, e só o teste de citação revela essa lacuna.
Como a Ande ajuda sua empresa com SEO técnico
A Ande Media trata o SEO técnico como a base que sustenta a visibilidade em buscadores e em IAs.
O trabalho começa por uma leitura do que robôs tradicionais e rastreadores de IA conseguem acessar hoje, e termina com um plano de correções ordenado por impacto.
Como agência de GEO, a Ande cruza o diagnóstico técnico com o teste de citação, e assim mostra quais problemas de código estão custando menções reais. Na prática, a entrega inclui:
- Auditar rastreamento, indexação, renderização e velocidade das páginas prioritárias.
- Corrigir robots.txt, canonicals, redirecionamentos e dados estruturados.
- Ajustar a renderização de páginas que dependem de JavaScript.
- Medir a visibilidade da marca em ChatGPT, Perplexity e Gemini antes e depois das mudanças.
Peça o diagnóstico gratuito de SEO técnico da Ande e descubra o que está impedindo buscadores e IAs de ler o seu site.